适用对象:使用期魔方证券版进行自定义因子编写与因子检验的用户。 阅读前提:已安装期魔方客户端,能正常登录并查看行情。 你将学会:理解因子与因子分析是什么 → 学会在因子库里管理因子 → 会创建分析任务并运行 → 了解因子文件的整体框架。
因子分析是什么
因子是一个打分函数:在每个时点,对股票池里的每只股票算出一个分数(因子值),分数的高低代表"这只股票未来更可能涨还是跌"。例如:动量因子给"近期涨得多"的股票打高分,低波动因子给"波动小"的股票打高分。
因子分析是对因子做独立的量化检验,与策略编写、回测相互独立。它回答三个问题:
| 问题 | 靠什么回答 |
|---|---|
| 这个因子有没有预测力? | Rank IC(因子值与未来收益的秩相关) |
| 预测力稳不稳定? | ICIR、IC 胜率、分年度/分状态稳定性 |
| 按这个因子交易能不能赚钱? | 分位组收益、多空收益、换手率、成本容量 |
因子的编写与策略无关:因子只负责打分,不做交易;分析模块负责验证打分的预测能力,验证通过的因子才有资格作为策略的入场条件。
整体操作路径
一句话概括:先在因子库里写好并编译因子,再针对指定品种池与时间区间创建分析任务,系统自动计算 IC、分位组收益、换手率等指标并输出报告,最后可用多因子分析对多个因子做对比、去重与合成。
因子库 → 新增/编写因子 → 编译 → 新建因子任务 → 运行任务 → 查看任务详情(图表 / IC 汇总 / 诊断 / 预处理 / 分析参数 / 深度分析)→ 多因子分析
在因子库中管理因子
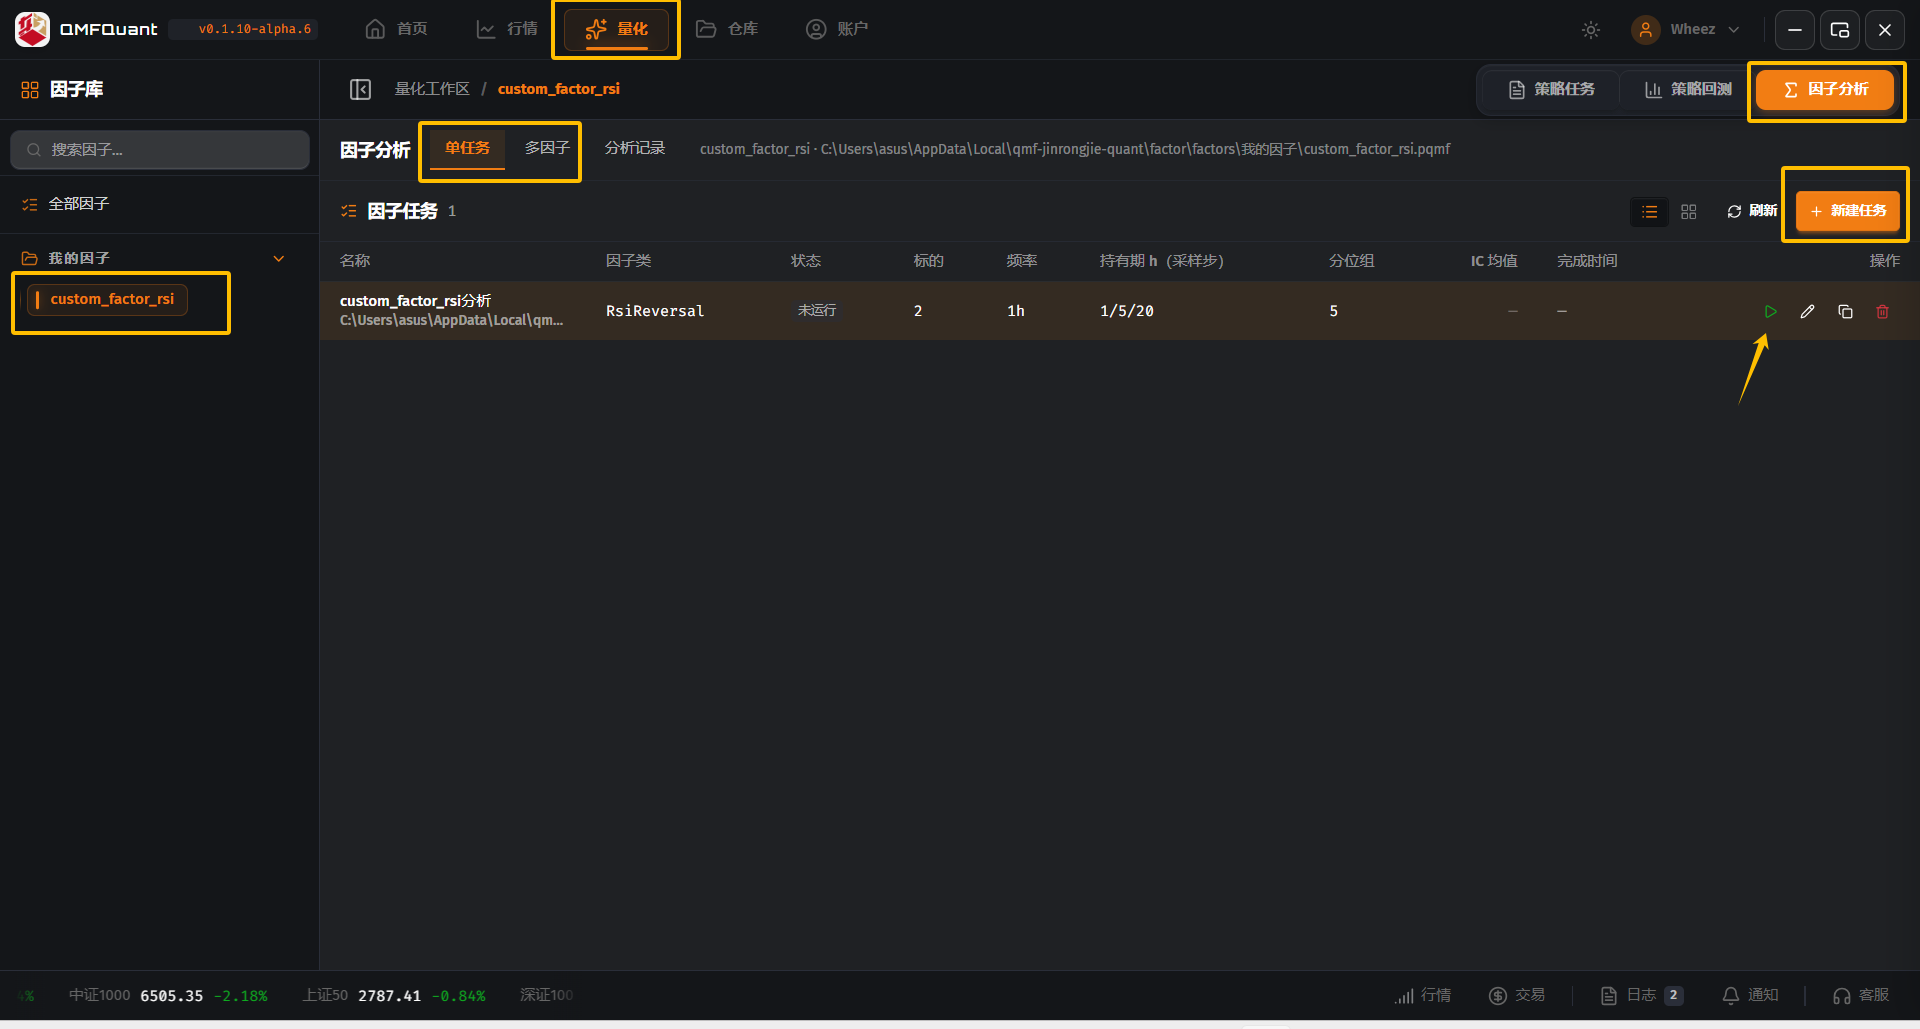
因子文件统一在"因子库"中管理。进入方式:顶部主导航点击"量化",切换到"因子库"标签页(与"策略库""指标库"同级)。
| 操作 | 说明 |
|---|---|
| 新建分组 | 点击左侧"新建"创建因子文件夹,分类存放不同类型的因子 |
| 新增因子 | 点击右上角橙色"新增因子"按钮,新建后自动关联代码编辑器,编写与编译方式与策略文件一致 |
| 文件形态 | 同一因子有源码(.py)与密文(.pyqmf)两种形态:源码用于编写调试与版本管理;密文用于加密分发,并直接作为因子分析的分析对象 |
| 状态查看 | "状态 / 最后保存"列显示编译结果:已编译显示"已完成 · 最后保存 <时间>";仅导入尚未编译的显示"未验证本机加载与编译" |
| 编辑与编译 | 源码文件的操作列提供"编辑"和"编译";修改代码后必须重新编译,新状态才会生效 |
| 导入导出 | 右上角"导入"可从本地上传因子文件;勾选后可"导出选中""删除选中"批量处理 |
| 检索筛选 | 顶部搜索框按名称模糊检索,下拉可按分组与状态过滤 |
创建并运行分析任务
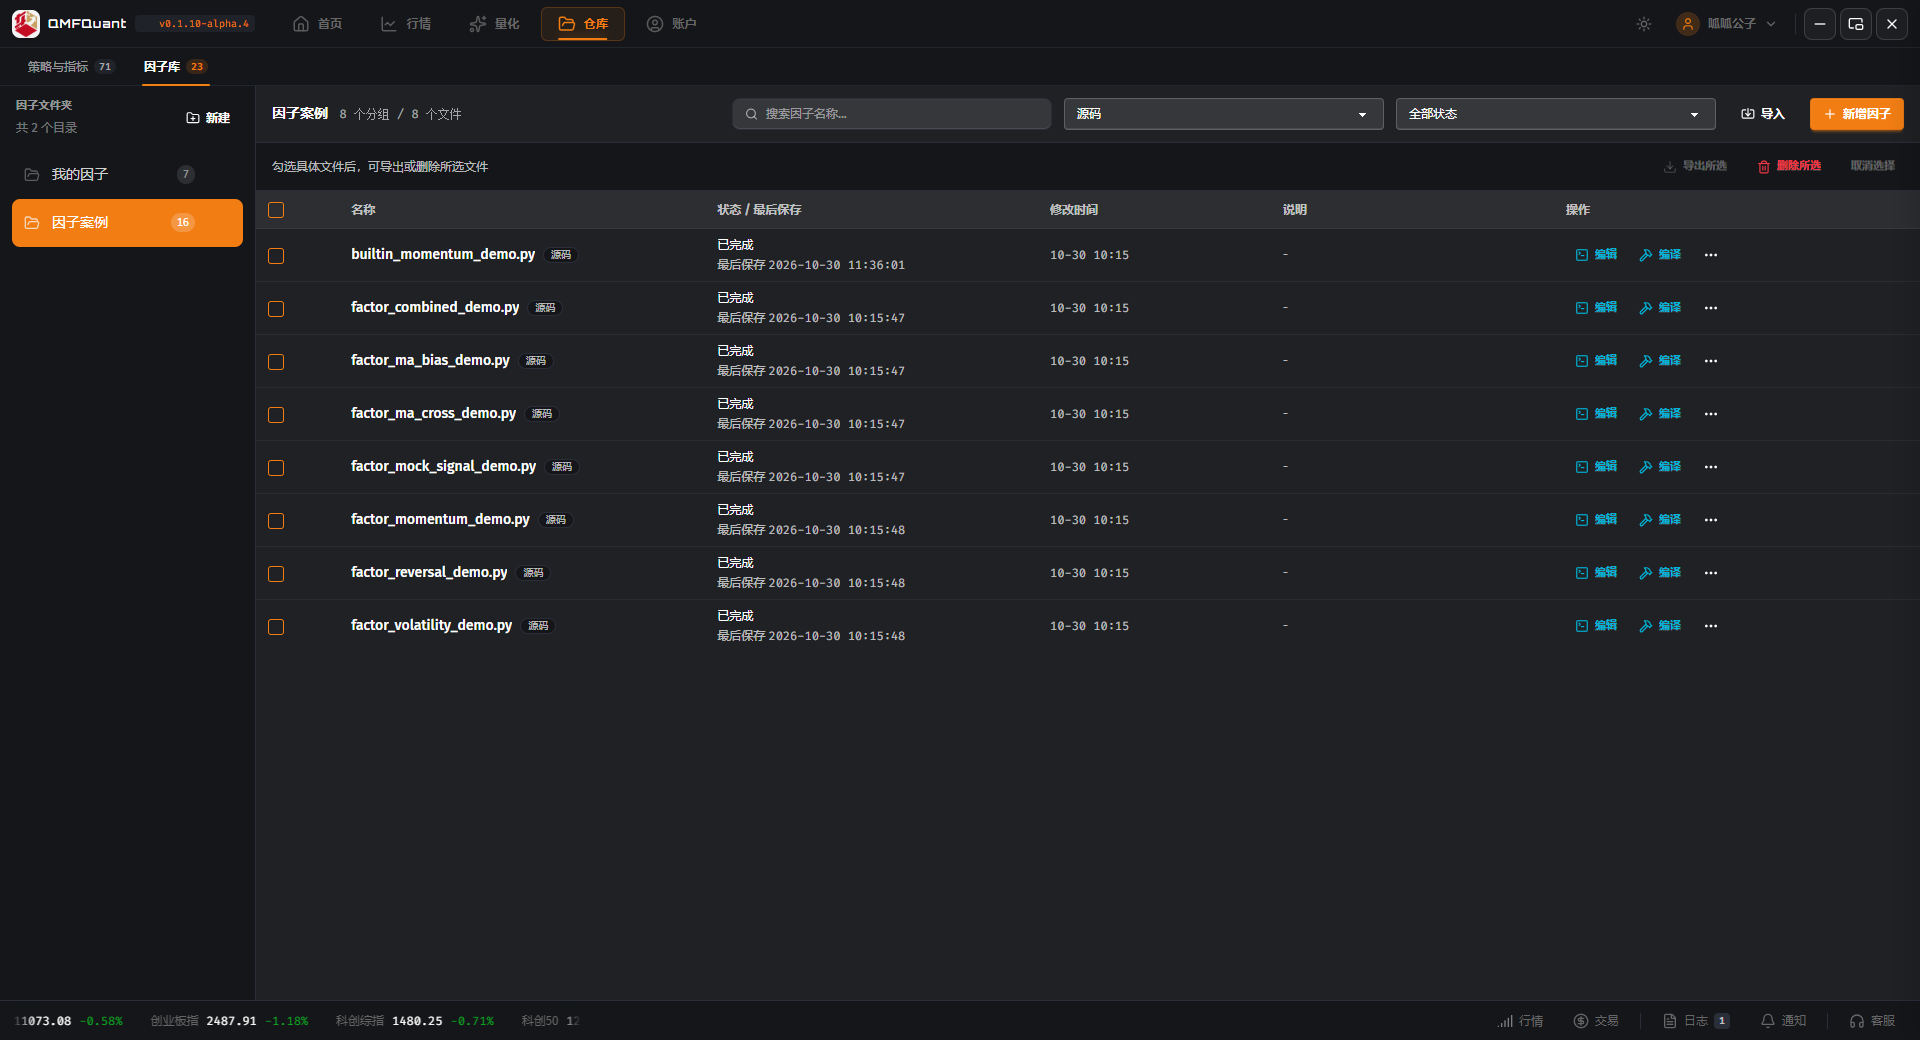
- 顶部导航点"量化",在左侧因子库中选中要分析的因子文件;
- 点右上角"因子分析",切到"单任务"页签,点"新建任务";
- 在新建任务窗口填写任务名称、分析区间、采样频率、持有期与分组组数,右侧选好品种,点"创建任务";
- 回到任务列表点绿色三角运行;跑完点任务名称,即可查看图表、IC 汇总、诊断与深度分析。
有多个候选因子时,切换到"多因子"页签做对比、去重与合成。
因子文件框架总览
一个因子就是一个 .py 文件,放在因子库的目录下。文件里一个参数类 + 一个因子类,框架只认因子类的 compute 方法:
custom_factor_xxx.py
├─ import pandas / numpy / pydantic        ← 只用这三个库
├─ class Params(BaseModel):                ← 参数声明(可选)
│       window: int = Field(...)
└─ class MyFactor:                         ← 因子类(全文件只能有一个)
       LABEL = "中文名"                     ← 界面显示名(可选)
       DESCRIPTION = "一句话说明"            ←(可选)
       PARAM_MODEL = Params                 ← 挂接参数(可选)
       def compute(self, prices, params, context):   ← 唯一必须实现的方法
           return df  # 三列 ts / asset / value
各位置职责与缺失后果:
| 位置 | 写什么 | 是否必须 | 缺失或错误的后果 |
|---|---|---|---|
class Params(BaseModel) |
参数名、类型、默认值、取值范围 | 建议 | 不需要参数时可省略,compute 内使用常量 |
| 因子类 | 因子逻辑的容器,类名自定 | 必须 | 报"未找到因子类" |
LABEL |
界面展示的中文名 | 可选 | 界面显示类名 |
DESCRIPTION |
一句话说明因子含义 | 可选 | 界面无说明 |
PARAM_MODEL |
指向参数类,生成前端参数表单 | 可选 | 前端无参数输入框,params 收不到值 |
compute |
唯一必须实现的方法 | 必须 | 报"类缺少 compute 方法" |
下面是一个可直接运行的完整骨架(N 步动量因子),后续章节逐段解释每个部分的写法:
from __future__ import annotations

import pandas as pd
from pydantic import BaseModel, Field


class Params(BaseModel):
    """参数声明。没有 compute 方法,不会被当成因子类。"""

    window: int = Field(default=20, ge=2, le=250, description="回看窗口(网格步数)")


class MyFactor:
    """因子类。全文件只能有一个带 compute 的类。"""

    LABEL = "示例:N 步动量"
    DESCRIPTION = "现价相对 N 步前价格的涨幅"
    PARAM_MODEL = Params

    def compute(self, prices: pd.DataFrame, params: dict, context: dict) -> pd.DataFrame:
        window = int(params.get("window", 20))

        # 1) 长表 → 宽表。prices 只有三列 ts/asset/value,value 是
        #    任务"价格字段"选定的那一列行情。
        frame = prices[["ts", "asset", "value"]].drop_duplicates(
            subset=["ts", "asset"], keep="last"
        )
        wide = frame.pivot(index="ts", columns="asset", values="value").sort_index()

        # 2) 计算因子:wide 的行是时点、列是标的
        factor = wide / wide.shift(window) - 1.0

        # 3) 宽表 → 长表
        out = factor.reset_index()
        out.columns.name = None
        out = out.melt(id_vars="ts", var_name="asset", value_name="value")
        out = out.dropna(subset=["value"])
        out["ts"] = out["ts"].astype("int64")
        out["asset"] = out["asset"].astype(str)
        out["value"] = out["value"].astype(float)
        return out[["ts", "asset", "value"]].reset_index(drop=True)
compute 返回后,平台统一做以下善后(自己写干净更好,但平台会兜底):
- 丢弃
value为空(NaN)的行; - 同一
(ts, asset)有多行时只保留最后一行; - 校验
ts为 int64 纳秒、三列齐全,缺列或返回宽表直接报错; - 把因子值与行情对齐到分析网格,参与后续 IC 与分层收益计算。
评论
登录后参与讨论,与站内账号体系共用。